Active· since Jul 23, 2025
- 423
- days running
- 0
- relaunches
Ad copy
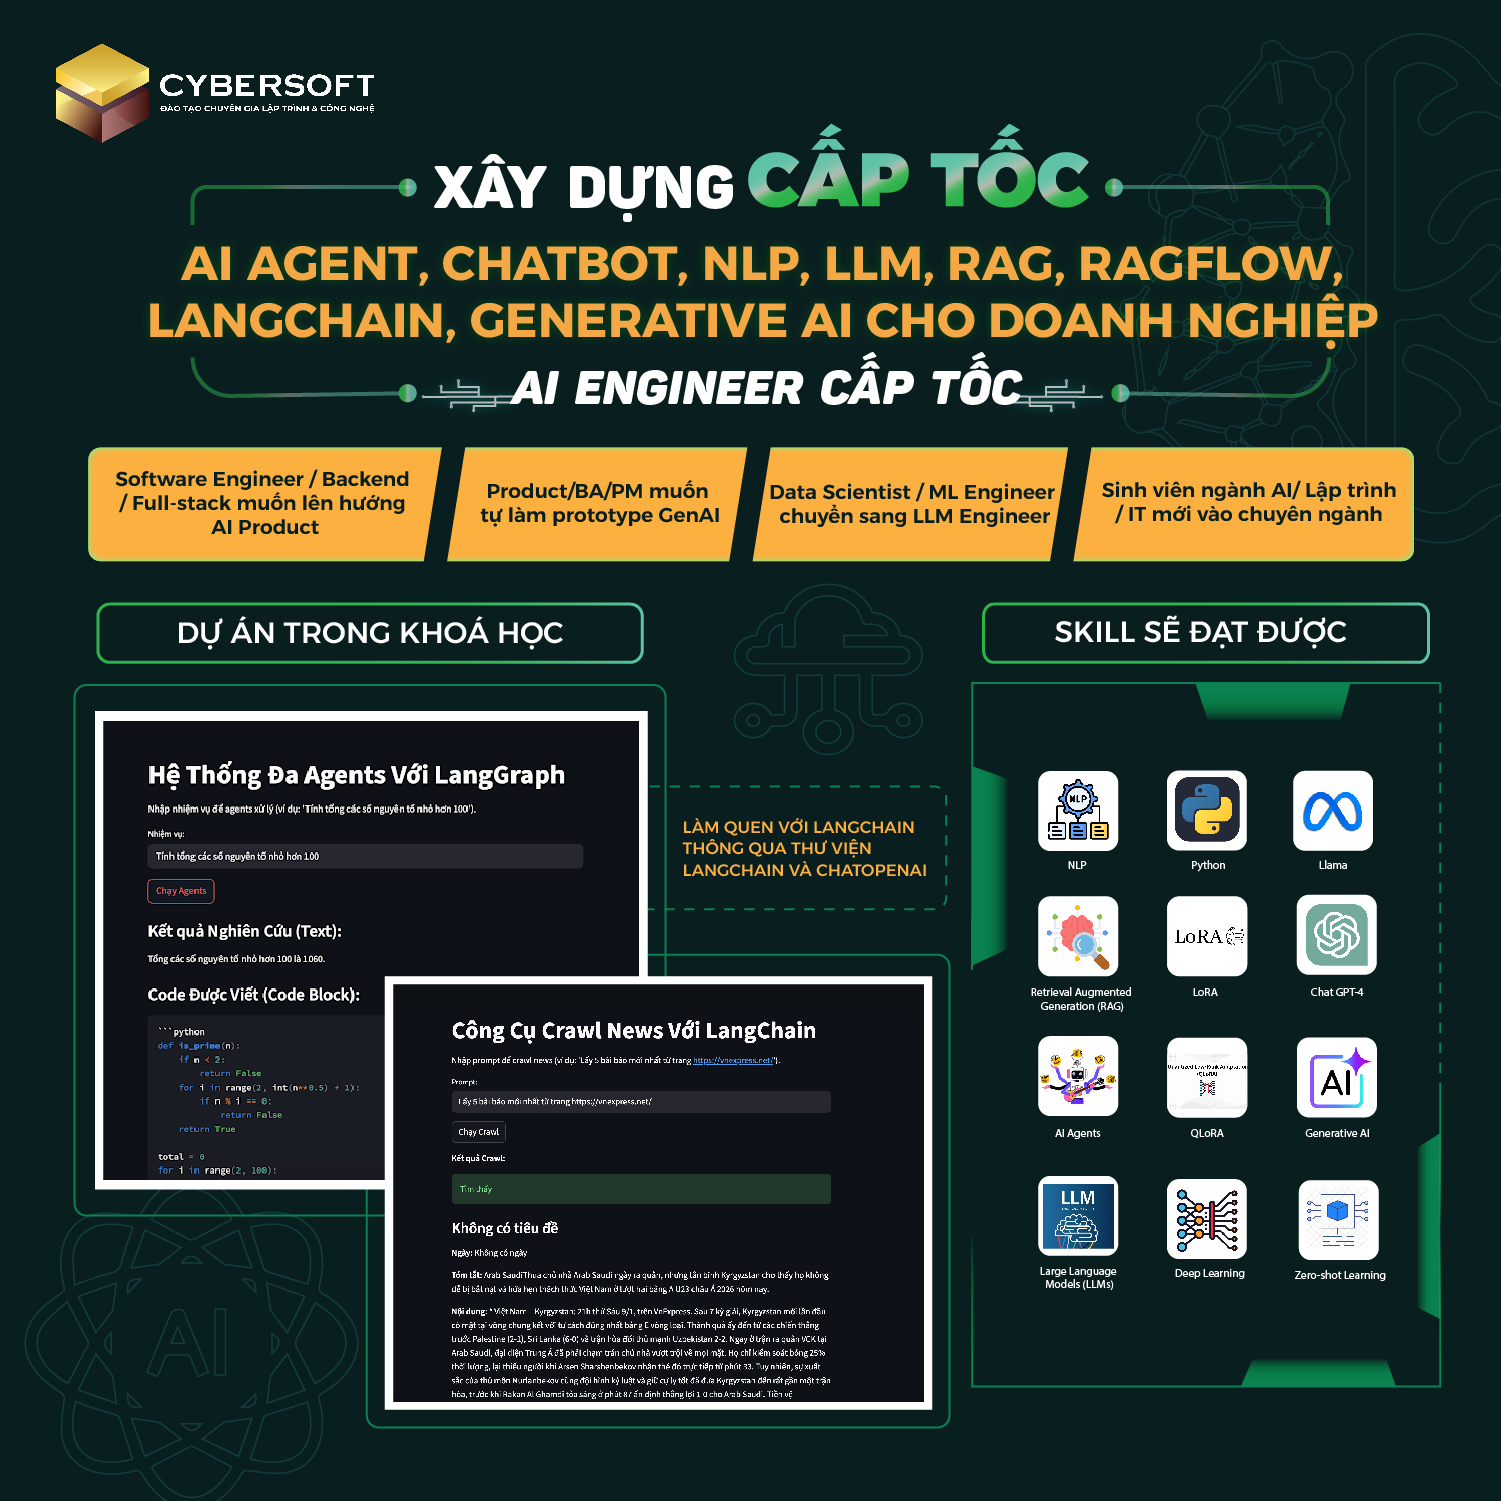
LỘ TRÌNH CHUYÊN SÂU: NLP, LLM, RAG, RAGFlow, LANGCHAIN, GENERATIVE AI VÀ AI AGENTS... Rồi đây, hàng loạt công ty sẽ cần những hệ thống ChatBot nội bộ thông minh để tối ưu hóa quy trình, từ chăm sóc khách hàng, truy xuất tài nguyên nhanh chóng, đến dự đoán và thống kê dữ liệu. Họ muốn mọi thứ được xử lý bảo mật, không rò rỉ dữ liệu, và được huấn luyện trên chính dữ liệu nội bộ của công ty. Với các dịch vụ cloud mạnh mẽ hiện nay, bạn có thể xây dựng và huấn luyện các mô hình AI tiên tiến mà không lo chi phí quá lớn. Quan trọng hơn, bạn sẽ làm việc với các mô hình open-source như LLaMA, BERT hay GPT, kết hợp với dữ liệu riêng của công ty để fine-tune, tạo ra những chatbot "may đo" giải quyết đúng nhu cầu thực tế. DEMO trong video mà CyberSoft đang triển khai trong khóa học NLP, LLM, AI Agent chuyên sâu đang xử lý gồm các tính năng: - Tải lên dữ liệu nội bộ (file PDF, DOCX, website). - Tìm kiếm ngữ nghĩa từ dữ liệu (vector search). - Tạo câu trả lời tự động dựa trên dữ liệu tìm được. - Hiển thị lịch sử hội thoại, cho phép chỉnh sửa, tải log. Workflow thực hiện: Câu hỏi đầu vào sẽ được xử lý bởi LLM, kết hợp cơ chế retrieval tìm kiếm vector từ bộ dữ liệu được index sẵn, sau đó LLM sinh câu trả lời có dẫn chứng, và hiển thị trực quan trên giao diện web. Dự án sử dụng các mô hình: LLM: OpenAI GPT-4, Llama, HuggingFace Transformers và một số kỹ thuật như Retrieval: FAISS vector database, semantic search,... Web App dùng Streamlit, LangChain. Database: Pinecone, ChromaDB hoặc Milvus. Môi trường phát triển: Conda, Python CÁC BẠN SẼ NÊN HỌC THẾ NÀO ? 𝟭. Xây gốc Kỹ sư 𝗔𝗜 – 𝗗𝗮𝘁𝗮 𝗦𝗰𝗶𝗲𝗻𝗰𝗲 với 𝗠𝗮𝗰𝗵𝗶𝗻𝗲 𝗟𝗲𝗮𝗿𝗻𝗶𝗻𝗴 & 𝗗𝗲𝗲𝗽 𝗟𝗲𝗮𝗿𝗻𝗶𝗻𝗴 - Điều bắt buộc để tiến xa trong sự nghiệp AI Engineer - Ngôn ngữ Python chuyên sâu cho AI - Thống kê & Xử lý dữ liệu (Pandas, NumPy, Matplotlib) - Machine Learning Algorithms: Linear Regression, KNN, SVM, Random Forest - Neural Networks với TensorFlow & Keras: hiểu rõ cách xây dựng và huấn luyện mô hình Deep Learning - CV và Natural Language Processing (NLP) - Các kiến thức về LOSS - Các kiến thức về Toán - Các kiến thức về huấn luyện mô hình, test, triển khai thực tế. Nhớ rằng build các dự án trong lúc học thì mới không chán được. 𝟮. 𝗔𝗜 𝗘𝗻𝗴𝗶𝗻𝗲𝗲𝗿 chuyên sâu với NLP, LLM, RAG, AI Agent, GenAI - Hiểu sâu về NLP nâng cao: từ vector hóa văn bản, kiến trúc Transformer, LLMs đến các kỹ thuật tối ưu như LoRA, QLoRA, Pruning, Quantization. - So sánh mô hình GPT, BERT, T5, LLaMA – ưu nhược điểm và ứng dụng trong pháp lý, tài chính, y tế. - Thành thạo Transfer Learning, Summarization, NER nâng cao. - Triển khai hệ thống Semantic Search, kết hợp Generative AI và Vector Search (FAISS, Pinecone). - Nắm vững các chiến lược tối ưu hóa mô hình NLP trong môi trường doanh nghiệp. - Thành thạo NLP thực chiến, ứng dụng được mô hình ngôn ngữ lớn vào bài toán pháp lý, tài chính. - Kỹ năng triển khai hệ thống tìm kiếm, chatbot, tổng hợp văn bản. - Kiến thức toán học: Attention Mechanism, Loss Function, Gradient Descent, Matrix Factorization, Optimization. - Thư viện sử dụng: HuggingFace, Transformers, SpaCy, FAISS, PyTorch TRANSFORMERS, LLMs & FINE-TUNING - Hiểu kiến trúc Transformer, cơ chế Attention, Encoder vs Decoder, Positional Encoding. - So sánh LLMs: GPT, BERT, T5, LLaMA, Mistral, ưu nhược điểm và ứng dụng. - Phân biệt Fine-Tuning toàn phần và PEFT (LoRA, QLoRA), áp dụng vào các lĩnh vực thực tế. - Giới thiệu Reinforcement Learning from Human Feedback (RLHF), mô hình Reward, Direct Preference Optimization. - Thành thạo Transformer, LoRA, RLHF, Reward Modeling. - Ứng dụng: chatbot, phân tích tài chính, pháp lý. - Kiến thức toán học: Attention, Reward Function, Policy Gradient. - Thư viện sử dụng: HuggingFace, PEFT, TRL, PyTorch. RAG & RAG Flow - Hiểu rõ cơ chế RAG và RAGFlow, kết hợp truy xuất + sinh văn bản. - So sánh hiệu năng RAG, FAISS, RAGFlow trong truy xuất tài liệu. - Tìm hiểu triển khai mô hình AI thực tế bằng FastAPI, Docker, MLflow, HuggingFace Spaces. - Tối ưu hóa LLM với Quantization, Pruning, Distillation, Scaling LLM bằng DeepSpeed. - Biết cách triển khai & tối ưu LLMs ở quy mô doanh nghiệp. - Làm chủ RAGFlow, MLOps, CI/CD cho mô hình AI. - Kiến thức toán học: Cosine Similarity, Gaussian Init, Gradient Checkpoint. - Thư viện sử dụng: FAISS, LangChain, MLflow, HuggingFace, DeepSpeed. XÂY DỰNG CHATBOT NỘI BỘ - Xây dựng một chatbot AI thông minh, có khả năng trả lời tự nhiên và chính xác các câu hỏi của khách hàng trong lĩnh vực thương mại điện tử. - Tìm hiểu và ứng dụng kiến trúc Transformer, Self-Attention, Multi-Head Attention trong xử lý ngữ cảnh. - Fine-tune mô hình LLaMA hoặc GPT bằng kỹ thuật LoRA và RLHF để tăng độ chính xác phản hồi. - Áp dụng LangChain và Hugging Face Transformers để triển khai pipeline hội thoại thông minh. - Sử dụng tập dữ liệu OpenAssistant để huấn luyện mô hình chatbot. - Tạo ra mô hình chatbot AI có khả năng trả lời sát ngữ cảnh và mang tính tự nhiên trong ngôn ngữ. - Kiến thức toán học: Attention Mechanism, Reinforcement - Learning, Gradient Descent, Loss Function Optimization. - Thư viện áp dụng: Hugging Face Transformers; TRL (Transformer Reinforcement Learning Library); LangChain. AI AGENTS, RAG, LANGCHAIN - Hiểu khái niệm AI Agents và cách hoạt động theo mô hình Orchestration sử dụng LLM. - Làm quen với LangChain và cách xây dựng workflow gồm nhiều bước reasoning logic. - Hiểu cách AI Agents tương tác với hệ thống qua API Integration, Chain-of-Thought Prompting. - Tối ưu hóa tìm kiếm bằng mô hình RAG, kết hợp mô hình thị giác BLIP-2 cho Visual QA. - Fine-tuning AI Agents với RAGFlow, so sánh các mô hình mới như RWKV, Mamba. - Xây dựng AI Assistant chuyên biệt cho doanh nghiệp trong các tác vụ tài liệu, tìm kiếm, tư vấn. - Kiến thức toán học: Cosine Similarity, Sequence Embedding, Prompt Engineering. Thư viện áp dụng: LangChain, OpenAI, HuggingFace, FAISS, BLIP-2 XÂY DỰNG HỆ THỐNG TÌM KIẾM CHO DOANH NGHIỆP BẰNG AI - Xây dựng hệ thống tìm kiếm tài liệu nội bộ doanh nghiệp, có khả năng trả lời câu hỏi dựa trên nội dung file (PDF, Word, CSV). - Ứng dụng kỹ thuật Retrieval-Augmented Generation (RAGFlow) để vừa truy xuất vừa sinh nội dung trả lời. - Tìm hiểu và sử dụng FAISS hoặc Pinecone để lưu trữ vector và tìm kiếm nhanh chóng. - Áp dụng Sentence Transformers để mã hóa văn bản. - Sử dụng LangChain Agents để điều phối truy vấn và tích hợp API (Google Drive, Dropbox). - Dữ liệu huấn luyện từ KILT Tasks Dataset. - Tạo công cụ tìm kiếm ngữ nghĩa hiệu quả cho tài liệu doanh nghiệp, có khả năng trả lời linh hoạt các truy vấn người dùng. - Kiến thức toán học: Cosine Similarity, Embedding Space, Information Retrieval, Semantic Search. - Thư viện áp dụng: LangChain; FAISS / Pinecone; Sentence Transformers; Hugging Face Datasets: facebook/kilt_tasks GANs, Diffusion Models, và Vision Transformer - Hiểu các kỹ thuật tối ưu Transformer: Sparse Attention, FlashAttention v2, MoE. - Nắm được Long-context modeling: Longformer, RWKV, Mamba, S4, Mega. - Làm chủ hệ thống Large-scale RAG và các framework như FAISS, Pinecone, ChromaDB. - Áp dụng Multimodal AI: kết hợp NLP với hình ảnh, âm thanh BLIP2, Flamingo, Whisper, Gemini AI. - Phân biệt, đánh giá mô hình Multimodal trong Visual QA và chatbot đa phương thức. - Tối ưu hóa Transformer (Sparse, MoE), xây dựng hệ thống RAG nâng cao, triển khai AI Assistant đa phương thức. - Chatbot xử lý tài liệu dài, truy xuất tri thức đa kênh (văn bản, ảnh, âm thanh). - Kiến thức toán học: Attention Variants, ANN, Cross-modal Embedding - Thư viện áp dụng: HuggingFace, FlashAttention, LangChain, Gemini, Zapier. TốI ưu prompt và xây dựng AI Agents với LLMS và các kỹ thuật tiên tiến - Tối ưu Prompt với: Chain-of-Thought, Graph-of-Thoughts, Program-of-Thoughts. - Reinforcement Learning for Prompt Optimization: DPO, RLAIF. - Tư duy nâng cao: Self-Reflection, Meta-Reasoning trong LLMs. - Xây dựng AI Agents bằng AutoGPT, CrewAI, Reflexion, LangGraph, DSPy. - Triển khai LLMs hiệu quả: Knowledge Distillation, Quantization, Pruning, DeepSpeed. - Làm chủ kỹ thuật tối ưu Prompt: CoT, Graph-of-Thoughts, RLAIF, xây dựng AI Agents. - Triển khai AI Chatbot/Assistant thông minh, deploy LLMs trên Edge AI với mô hình nén và lượng tử hóa. - Kiến thức toán học: Graph Theory, MDP, Information Theory. - Thư viện áp dụng: LangChain, HuggingFace, Zapier, vLLM, DSPy. TốI ưu mô hình AI cho thiết bị tài nguyên thấp: distillation, quantization, pruning và inference optimization - Hiểu các kỹ thuật tối ưu mô hình để triển khai trên thiết bị tài nguyên thấp. - So sánh tốc độ suy luận bằng FlashAttention v2. - Phân tích trade-off giữa hiệu suất và kích thước mô hình. - Viết báo cáo triển khai LLMs trên thiết bị Edge AI. - Làm chủ các kỹ thuật tối ưu mô hình: Knowledge Distillation (Teacher, Student, DistilBERT, TinyLLaMA), Quantization (GPTQ, AWQ, 4-bit/8-bit), Pruning (Structured vs. Magnitude), và Inference Optimization (FlashAttention v2, vLLM, DeepSpeed, TensorRT). Xây dựng AI Agent tự động tìm kiếm, phân tích và sinh nội dung chuyên sâu từ dữ liệu phi cấu trúc - Xây dựng một AI Agent có thể tự động tìm kiếm, phân tích, tóm tắt và sinh nội dung chuyên sâu từ hàng triệu tài liệu, giúp doanh nghiệp khai thác tri thức từ dữ liệu phi cấu trúc (hợp đồng, báo cáo nghiên cứu, tài liệu nội bộ). - Tìm hiểu cơ chế hoạt động của Generative AI và RAG để xử lý dữ liệu lớn và phi cấu trúc. - Áp dụng kỹ thuật Fine-tuning trên các LLM như GPT-4, Claude, LLaMA bằng dữ liệu doanh nghiệp với LoRA/QLoRA. - Tích hợp FAISS/Pinecone để truy xuất thông tin nhanh dựa trên embeddings. - Kết hợp LangChain và AutoGPT để triển khai tác nhân AI có khả năng tự đặt mục tiêu và hành động theo chuỗi. - Nâng cao khả năng trích xuất thông tin nhờ NER. - Thư viện áp dụng: LangChain, AutoGPT, FAISS / Pinecone, Hugging Face Transformers, Sentence Transformers, SpaCy / Flair (cho NER), Tesseract OCR + CRNN, PhoBERT / BERT, Wav2Vec 2.0, ResNet50, VAE + TTS (Tacotron2 / FastSpeech), Stable Diffusion, SpaCy / Flair (NER tùy biến). Phát triển hệ thống AI/NLP cho bảo tồn và số hóa di sản văn hóa phi vật thể - Phát triển một hệ thống AI/NLP chuyên sâu phục vụ bảo tồn và số hóa di sản văn hóa phi vật thể Việt Nam, với khả năng phân tích ngôn ngữ, trích xuất nội dung văn bản, và sinh mô tả chi tiết từ các nguồn đa phương tiện như âm thanh dân ca, video múa nghi lễ, tài liệu văn hóa truyền thống. - Hệ thống hỗ trợ giảng dạy, truyền thông và lưu trữ di sản dưới dạng dữ liệu số. - Hệ thống sử dụng OCR nâng cao (Tesseract + CRNN) để trích xuất văn bản từ hình ảnh và video, kết hợp BERT/PhoBERT phân tích ngữ nghĩa lời dân ca và văn bản cổ. - NER tùy biến nhận diện thực thể văn hóa, VAE + TTS tái tạo giọng đọc dân gian. - NLP đa phương thức với Stable Diffusion sinh mô tả và ảnh minh họa từ dữ liệu đa dạng. CHI TIẾT 2 CHƯƠNG TRÌNH DƯỚI COMMENT NHÉ CÁC BẠN 👇
Like this ad? Make it yours.
Crush rebuilds this exact creative around your product — your brand, your colors, your offer — in about a minute.